
来源说明:本文原载于 Vane 博客,原文发表于 2026 年 10 月 22 日。正文、表格和代码沿用原中文版本;文档相对链接改为绝对地址,阅读说明以引用块呈现。配图在本站托管,中文版保留原有中文图示;英文版的三张演示界面图和日文版的五张配图已翻译并重绘,保留作者名、时间点和原始材料,重绘的演示界面图已注明来源。
同一个测评话题,往往有多位博主发布视频。内容有所重叠,关注点和测试条件却不一定相同。观众需要知道哪些片段回答了自己的问题、每支视频提供了什么信息。本文记录一次基于 Vane Data 和 HawDB 的多视频比较实践:整理字幕与画面,按问题提取说法、核对条件,再把比较结果关联到原视频的位置。
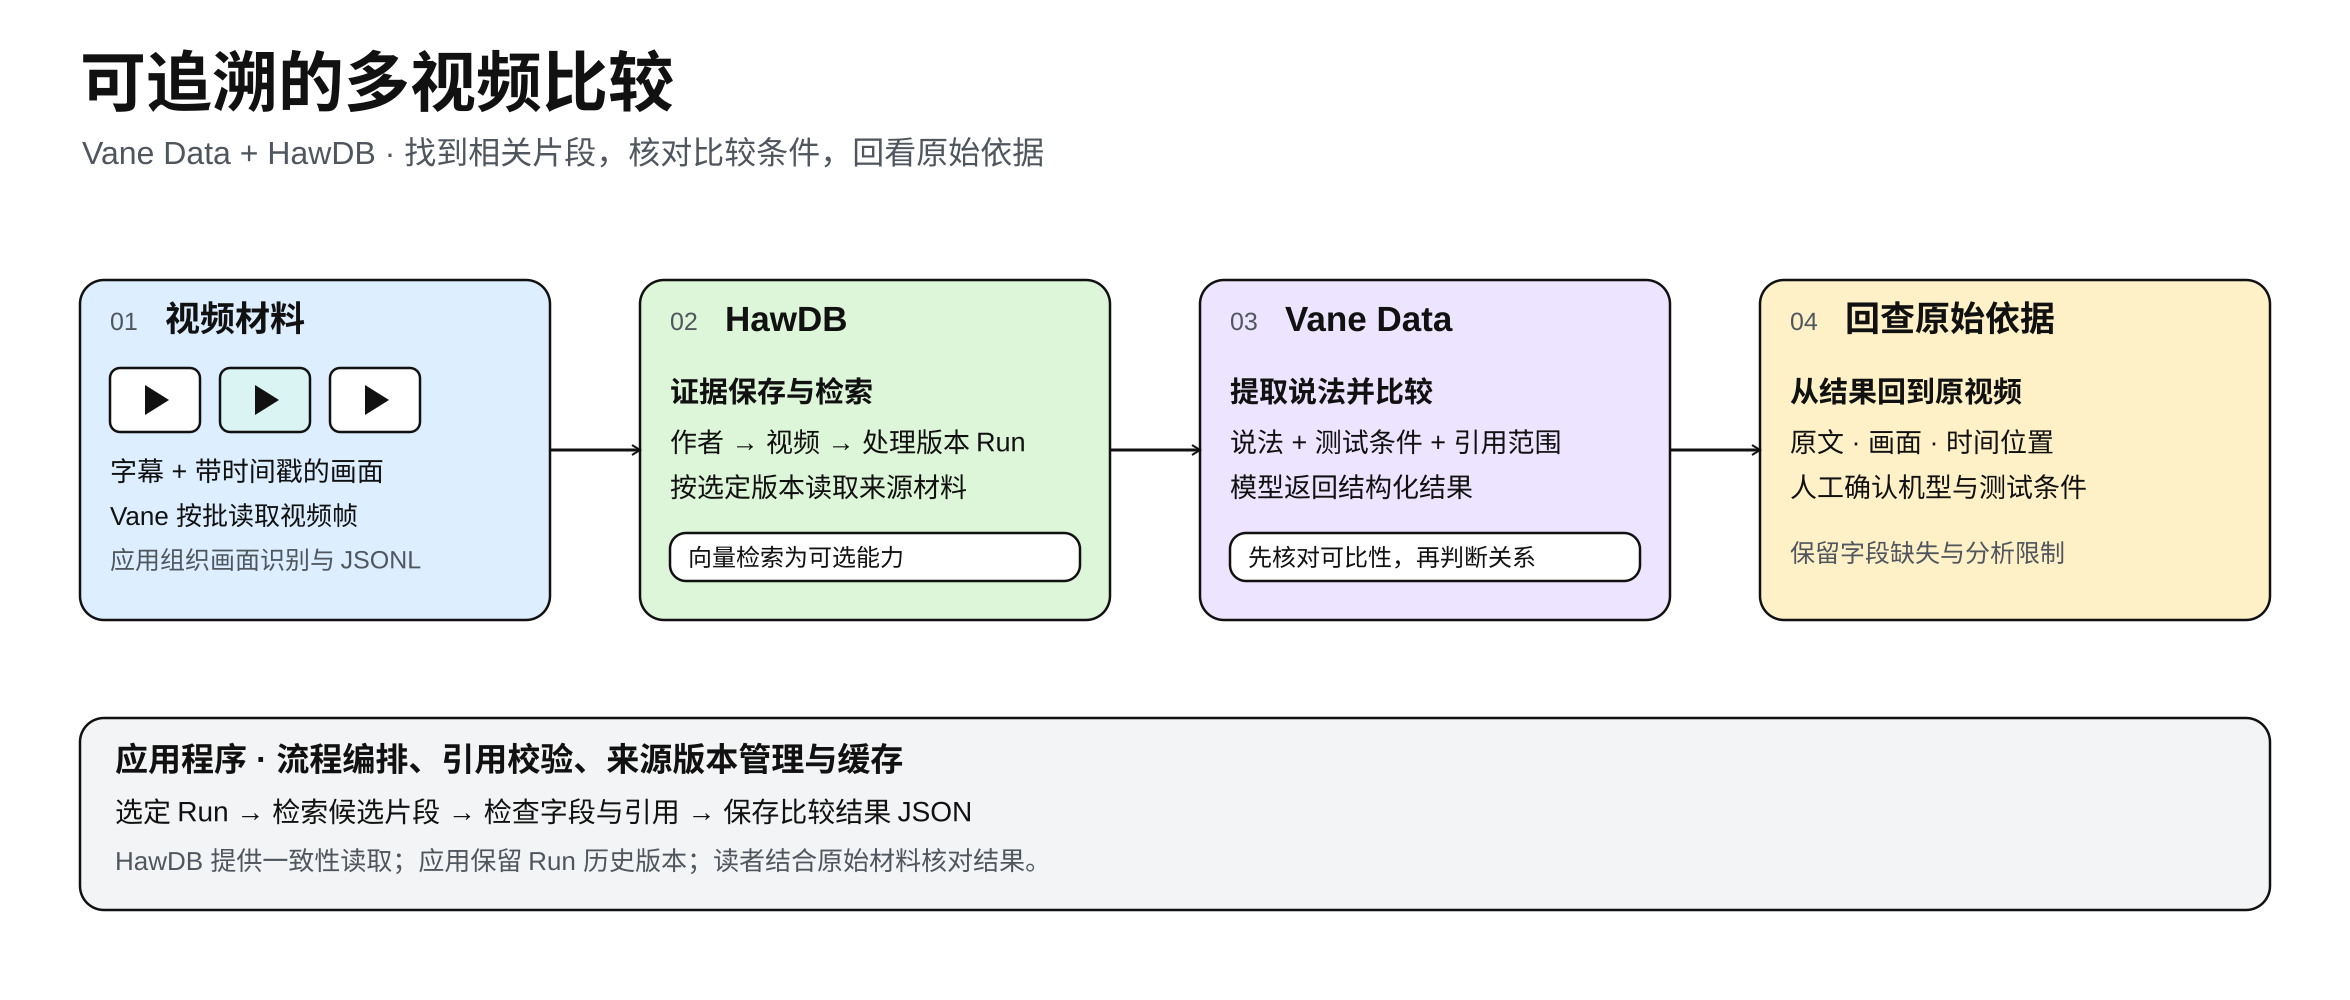
这套流程把字幕、视频画面和模型输出组织成可继续处理的数据,并保留每次分析使用的材料。Vane Data 提供多模态数据接口与结构化模型调用,HawDB 提供图关系、事务读取和可选的语义检索,应用程序将这些步骤串联起来。
阅读说明.
本文以一次多视频比较 PoC 为例,区分当时的自动分析结果与后来人工回看原片的核对结果。演示页面中的摘要和观看建议已经过预先整理,不是实时生成的完整视频分析。代码展示关键步骤,数据库导入、服务配置和完整异常处理从略;
video_path、output_dir、question、passages与model_options由应用提供,不构成可直接运行的完整脚本。
从多视频比较场景开始
这里以影视飓风和极客湾的两段字幕为例,并用钟文泽、何同学的片段补充画面提取和测试时长。下文分别展示自动分析与人工核对的结果,说明如何从相关片段找到依据,再进行比较。
系统将四支视频汇集成了一份导读。用户可以输入“续航”“视频录制”等话题,查看各位作者讨论了什么,再打开相关片段,核对原文和测试条件。
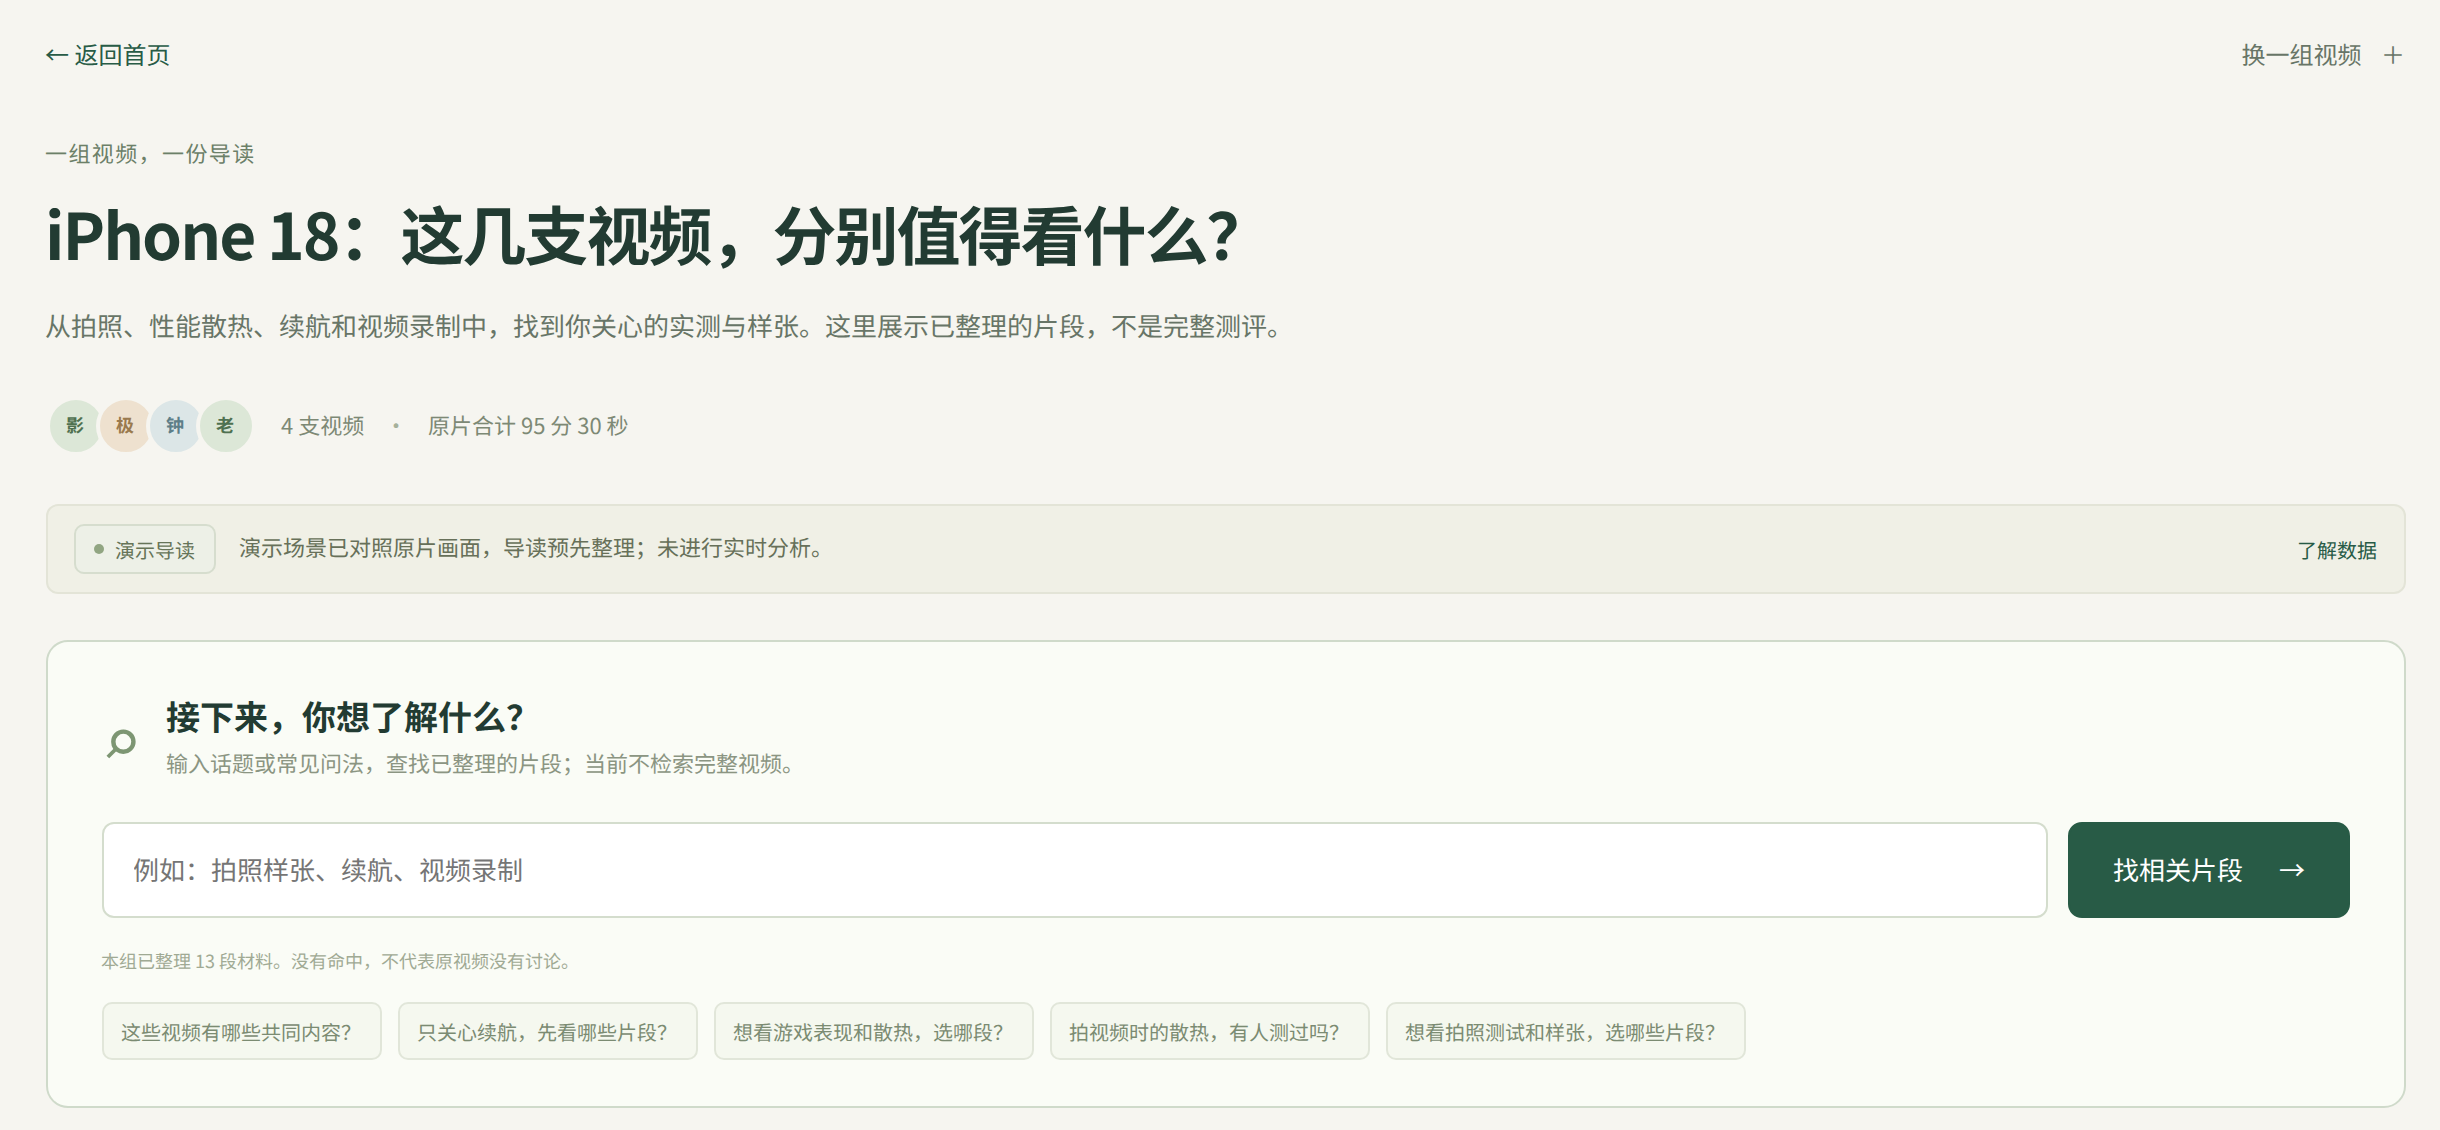
从四支视频的共同话题进入,按作者查看摘要与片段入口,再选择需要回看的内容。页面用于演示从查找片段到回看原片的过程;后文的提取字段和比较标签来自一次实际运行,保留了当时的遗漏。
案例:两段 iPhone 18 发热描述能否直接比较
当时用来检索和比较的问题是:
iPhone 18 Pro 散热改进带来了哪些收益和代价?
系统找到了两段与发热有关的描述。回看原片后发现,其中一段讨论的是 Duo,而不是问题中的 iPhone 18 Pro。比较前,需要先检查片段讨论的对象,以及测试条件是否支持直接比较。
下表是回看原片后的核对结果;后文仍保留当时自动提取的字段和比较标签,便于对照。
| 来源 | 材料中的描述 | 原片回查位置 |
|---|---|---|
| A:影视飓风 | 描述 Duo 录制约三分钟 4K60 视频后的局部发热与握持感受,称“烫到快握不住” | 12:46–13:16;12:47 的画面字幕明确提到 Duo |
| B:极客湾 | 描述 iPhone 正面热平衡温度约 44–45°C;图表分别标出 iPhone 18 Pro Max 为 44.3°C、17 Pro Max 为 45.2°C,测试条件为高负载烤机 30 分钟 | 17:23–17:37;测试时长见 17:08 起的上下文 |
两段描述涉及不同设备和测试场景,不能据此认为两位作者的结论相互矛盾。
最初提取的引用并不完整:A 从 12:53 开始,遗漏了此前提到 Duo 的内容;B 保留了温度描述,却遗漏了前面的“30 分钟压力测试”条件。因此,检索到相关片段后,还需要结合前后字幕和画面确认机型与测试条件。
整个流程分为三步:保存带来源的字幕和画面;按问题检索、提取说法并核对条件;将比较结果关联到原视频的位置。
Vane Data 与 HawDB:多模态数据如何流转
Vane Data 是面向 AI 工作负载的多模态数据引擎,提供 Python 和 SQL 接口,支持图像、视频、文本等数据的处理与模型调用。
在本次 PoC 中,Vane 负责读取视频画面,并调用模型分析字幕和图像,提取说法、识别测试条件、判断不同说法能否比较。应用程序负责串联步骤,检查返回内容是否有原文依据、引用位置是否准确。
Vane 用表处理接口衔接视频读取与模型调用:前者返回带时间戳的帧记录,后者接收文本、图像等列并返回结构化结果。应用沿用列选择和 Arrow 数据交换连接这些步骤,让提取出的条件、结果和引用编号进入后续校验与比较。
HawDB 是用 Rust 编写的多模态嵌入式数据库,支持 Cypher 查询和事务读写。本次 PoC 用它保存视频元数据、字幕、画面识别记录及来源关系,记录每次处理使用的数据版本。启用语义检索后,HawDB 还保存文本和向量,执行相似度查询。它在本地嵌入运行,无需额外部署数据库服务。
图查询回答“材料来自哪位作者、哪个视频、哪次处理”,向量检索回答“哪些内容与当前问题相关”。应用通过证据编号连接两者,使检索结果仍能追溯到具体来源。
| 环节 | 工具提供的能力 | 应用负责的工作 |
|---|---|---|
| 整理画面 | Vane 按批返回视频帧及时间 | 设置采样间隔和尺寸、保存 PNG、识别画面文字 |
| 语义检索(可选) | FastEmbed 生成向量;HawDB 保存文本、向量及来源信息,执行相似度查询 | 组织文本块、管理索引版本、筛选候选片段 |
| 提取与比较 | Vane 组织文本、图像输入和结构化返回 | 组织候选材料、编写提示词、检查字段与引用 |
| 保存与回查 | HawDB 保存证据和来源关系,提供事务读取 | 定义来源版本、绑定引用和播放位置、管理缓存 |
原始视频和提取出的 PNG 保存在本地文件系统中。字幕和画面识别记录整理成 JSONL,由 Rust 导入程序写入 HawDB。应用将比较结果保存为 JSON,记录本次分析使用的数据版本。
下面通过视频帧读取、来源查询、语义检索和说法提取的代码说明各步骤的输入与输出,不展开数据库导入、服务配置和完整异常处理。
构建可追溯的多模态数据流
多模态数据采集与结构化
A、B 两段视频都使用了字幕,入库时保存字幕原文及起止时间。没有字幕时,通过 faster-whisper 转写。画面中的图表和文字则通过抽帧与图像识别提取,同时保留画面时间和原图位置。
下面使用 Vane 每隔 5 秒提取一帧,将画面保存为 PNG,文件名采用对应的毫秒时间戳。video_path 是本地视频路径,output_dir 是预先准备的空目录;此处未指定 frame_limit。
from pathlib import Path

from PIL import Image
import vane

con = vane.connect()
height, width = 720, 1280
frames = vane.read_video_frames(
    video_path, image_height=height, image_width=width,
    sample_interval_seconds=5.0,
    connection=con,
)
with frames.select("frame_time", "data").to_arrow_reader(batch_size=4) as reader:
    for batch in reader:
        times = batch.column("frame_time").to_pylist()
        for timestamp, frame in zip(times, batch.column("data"), strict=True):
            pixels = frame.value.values.to_numpy().reshape(height, width, 3)
            path = Path(output_dir) / f"{round(timestamp * 1000)}.png"
            Image.fromarray(pixels).save(path)
frame_time 的单位是秒,data 中的 RGB 像素按读取时指定的尺寸还原。batch_size=4 表示每批读取四帧,不是总帧数限制;扫描仍受 API 的输入大小、解码帧数等安全上限约束。下文复用 con,全部处理结束后调用 con.close()。
每个选中的视频帧在 Vane 中是一行数据:frame_time 是时间列,data 是图像列。应用通过 select() 一起读取,再用 Arrow reader 逐批取得像素,无需先汇集整个视频的全部抽样帧。
画面与时间的对应关系随数据保留。后续识别图表文字或将图片交给模型时,应用可以把结果绑定回这一行的帧时间。保存 PNG 是本例为回查原图选择的落盘方式;帧读取、列选择与批次输出由 Vane 提供。
应用随后通过 Vane 调用模型,识别画面文字,并记录视频来源、画面时间和 PNG 路径。这些结果与字幕一起保存,供检索和比较使用。接口细节见 read_video_frames 文档。
每隔 5 秒抽帧可能遗漏短暂出现的图表。检查某个片段时,可以缩短到 1–2 秒,但采样越密,存储和识别成本越高,也无法保证捕获所有画面信息。
以此前处理的钟文泽视频为例,系统从 16:48.583 的画面中识别出:iPhone 18 Pro Max 录制 15 分钟 4K120 视频后,耗电量为 4%。回看发现,参与对比的 iPhone 17 Pro 电池健康度为 98%,另外三款为 100%;这项条件没有被提取出来。保留原图有助于补查遗漏,而画面中的耗电数据只能反映该测试下的电量消耗,不能据此判断散热效果。
数据持久化、版本管理与来源追踪
应用把字幕和画面记录交给 Rust 导入程序,写入 HawDB。每条证据保存原文或画面识别结果、时间和内容哈希,通过 run_id 关联处理版本(Run)。数据库同时记录作者、视频和片段之间的关系。
材料读取实现通过下面的 Cypher 查询取得作者、视频和处理版本。查询来自 PoC 的 src/corpus.rs,仅调整了排版:
MATCH (a:Author)-[:PUBLISHED]->(v:Video)-[:PROCESSED]->(r:Run)
RETURN a.payload AS author, v.payload AS video, r.payload AS run
ORDER BY v.id, r.id
LIMIT 1001
PUBLISHED 表达作者与视频的关系,PROCESSED 连接视频与处理版本。应用取出 Run 编号,再读取对应证据:
MATCH (e:Evidence)
WHERE e.run_id IN $runs
RETURN e.payload AS payload
ORDER BY e.run_id, e.start_ms, e.id
SKIP $offset LIMIT $limit
$runs 来自上一步,$offset 和 $limit 用于分页。图关系查询确定来源,属性条件筛选证据,两者都使用 HawDB 的查询接口。读取的材料既有内容,也有作者、视频和处理版本,供后续引用绑定。
字幕或采样配置变化时,应用创建新的 Run,并保留旧版本。比较开始前,应用选定已完成的 Run,通过 run_id 读取对应证据。这些选定版本的材料称为“来源快照”。
所有证据在同一个 HawDB 读事务中读取,然后交给检索流程。比较结果也记录使用的来源版本,字幕日后更新时,仍能找到当时的依据。
这两类保证来自不同层次:读事务使来源关系与分批读取的证据处于同一次一致性读取中;应用创建并保留 Run,使历史结果能定位到旧材料。版本如何命名、何时创建、保留多久,由应用决定。
从数据检索到结构化分析
语义检索与候选数据筛选
用户提出问题后,应用从保存的字幕和画面记录中查找相关内容。它先按时间组织字幕片段,补充前后字幕,关联同一时间段的画面,使模型能够结合上下文理解内容。
关键词匹配依据视频标题、字幕和画面识别文字。启用语义检索时,FastEmbed 将材料与问题转为向量,HawDB 保存文本、向量及来源信息,并执行相似度查询。应用结合关键词和向量得分筛选、排序候选片段,按模型输入预算提交材料。
每个数据处理版本有对应搜索索引,可从原始记录重建。一条搜索记录包括文本块编号、文本、向量和来源元数据。字幕或画面文字分块后,evidence_id、video_id、run_id、kind 和 start_ms 一并进入元数据;块编号由证据编号与块序号组成,因此能对应回原始证据。
构建索引时,FastEmbed 在 Python 端计算向量,Rust 导入端通过 HawDB 的 SearchDocument 写入文本、向量和元数据。查询由 HawDB 执行向量相似度搜索与元数据过滤,应用再将命中结果归入视频片段。
没有配置嵌入模型时,只使用关键词检索。下面是 Rust 查询端的语义检索代码;它不代表后文那次实际比较启用了向量检索:
use hawdb::{SearchMode, SearchQueryOptions};
use std::collections::BTreeMap;

let result = index.search_with_options(
    "",
    Some(&query_vector),
    SearchMode::Vector,
    SearchQueryOptions {
        limit: document_count,
        offset: 0,
        rank_window: None,
        fusion_weights: Default::default(),
        metadata_filters: BTreeMap::from([("video_id".into(), video_id)]),
        policy_epoch: None,
    },
)?;
let hits: Vec<_> = result.hits.into_iter()
    .map(|hit| (hit.id, hit.vector_score))
    .collect();
index 包含选定版本的记录;query_vector 由 FastEmbed 生成并归一化。应用先通过索引确定数据范围,再用 video_id 筛选视频。document_count 是索引文档总数,此处作为返回上限,取得相关记录的向量得分,供应用与关键词得分结合排序。
hits 返回文本块编号和向量得分。应用通过编号找到原始记录,再将得分归入对应片段,形成后续使用的 passages:每个片段带有编号、字幕列表、时间范围及关联画面。
这里使用的是 SearchMode::Vector,关键词与向量得分的组合由应用完成。重新分块或更换嵌入模型时,应重建对应索引,原始证据和来源关系仍可保留。
结构化信息提取
找到相关片段后,应用通过 Vane 将内容交给模型,分别提取各视频的说法。每条只记录一项结果或评价,保留测试条件、对比对象、疑点,以及证据编号和字幕范围。信息缺失或型号无法确定时,字段留空。
下面以字幕为例,把 passages 和问题写入请求表。字段针对本次测评设计,其他题材可以调整。model_options 由应用配置,包含所选模型服务、模型名称与执行参数,具体参数见 Prompt API;con 沿用前面的连接。
模型返回的 evidence_id 对应输入片段的 id;first_cue 和 last_cue 是片段内从 1 开始的字幕编号,范围包含首尾两条。应用通过编号恢复字幕原文与时间。
import json
import pyarrow as pa
from pydantic import BaseModel, ConfigDict

class Statement(BaseModel):
    model_config = ConfigDict(extra="forbid")

    evidence_id: str
    first_cue: int
    last_cue: int
    target_model: str | None
    observed_result: str | None
    evaluation: str | None
    comparison_objects: list[str]
    conditions: list[str]
    uncertainties: list[str]

class Statements(BaseModel):
    model_config = ConfigDict(extra="forbid")

    selections: list[Statement]

request = {
    "question": question,
    "passages": [
        {
            "id": passage["id"],
            "cues": [
                [number, cue["text"]]
                for number, cue in enumerate(passage["cues"], start=1)
            ],
        }
        for passage in passages
    ],
}
relation = con.from_arrow(pa.table({
    "text": [json.dumps(request, ensure_ascii=False)],
}))
result = vane.ai.prompt(
    relation, vane.col("text"),
    return_format=Statements,
    system_message=(
        "围绕用户问题,从所给材料中提取有依据的陈述,每条只表达一个要点。"
        "保留主体、适用条件、数值单位及原文中的不确定性。"
        "仅引用输入中提供的证据编号和定位信息,不混合不同来源的陈述。"
        "evidence_id 使用片段 id,first_cue 和 last_cue 使用片段内的字幕编号,范围包含两端。"
        "按指定结构返回,缺失信息填 null 或 [],不得补充材料之外的信息。"
    ),
    **model_options,
)
extracted = Statements.model_validate(result.select("response").fetchone()[0])
return_format 指定返回结构。模型调用在读取 response 时执行,随后由应用检查结果。视频画面单独作为图像输入交给模型,再通过帧编号与时间恢复原片位置。
这段代码通过 con.from_arrow() 接收请求表,vane.col("text") 指定输入列,vane.ai.prompt() 声明调用与返回结构,再用表接口读取 response。本例将一组候选片段放进一条请求,所以输入表只有一行。
完整实现还将多条任务组织成包含 task_id、text、images 的表,把文本和图像列一同交给模型,按任务编号收集结果。Vane 提供多模态列输入和结果读取接口;任务划分、提示词、输入预算与完整性检查由应用控制。
Statements 说明下游如何使用输出:conditions 交给可比性判断,observed_result 与 evaluation 区分结果和评价,evidence_id 与字幕编号用于恢复引用。结构化返回让字段可检查,但字段是否准确,仍需通过证据校验确认。
应用检查片段编号是否来自本次输入、字幕范围是否有效,再恢复原文与时间,关联 run_id,并在引用前后各补一条相邻字幕。原文没有依据的字段会被移除,并记录为部分提取失败。
当时的自动分析确实遗漏了信息:影视飓风字幕提到“三分钟左右的 4K 60 帧视频”,模型没有提取成测试条件;极客湾字幕给出约 44–45°C,模型没有提取这一结果。后续比较仍需参考原始字幕。
数据校验与可比性判断
比较时,模型同时参考提取字段、引用原文和疑点,不能把未确认的信息当作事实,也不能自行补充测试条件。
它先核对对象、指标与条件,通过 comparability 记录可比性:comparable 表示可直接比较,different_conditions 表示对象或关键条件不同,unknown 表示信息不足。缺失条件不能默认相同。
之后再通过 relation 判断说法是一致、冲突、相互补充还是无法判断。这一步同样使用 vane.ai.prompt(),但调整输入、提示词与返回格式。
应用继续检查引用编号是否有效、两段说法是否来自不同视频,以及“一致”或“冲突”的判断是否满足 comparable 条件。这些是应用规则,模型判断仍需结合原文核对。
当时 A、B 两段内容得到的结果如下。复现这次分析需要相同的模型、提示词、代码和输入材料:
{
  "comparability": "different_conditions",
  "relation": "undetermined"
}
模型主要根据测试负载和观察位置的差异作出判断,没有识别出具体机型。Duo 与 Pro Max 的区别是后来人工回看才确认的,并未包含在当时的自动分析结果中。
测试时长同样影响比较。钟文泽在 16:38–16:59 展示录制 15 分钟 4K120 视频的测试;何同学在 11:17–11:28 比较 iPhone 16、17、18 Pro Max 录制半小时 4K120 视频后的温度。录制模式相同,时长却不同,不能直接比较温度表现。
结果溯源与证据回查
应用将问题、双方说法、比较结果和限制说明保存为 JSON。每条说法保留视频、来源版本 run_id、原文与时间位置,页面通过引用编号找到对应内容。
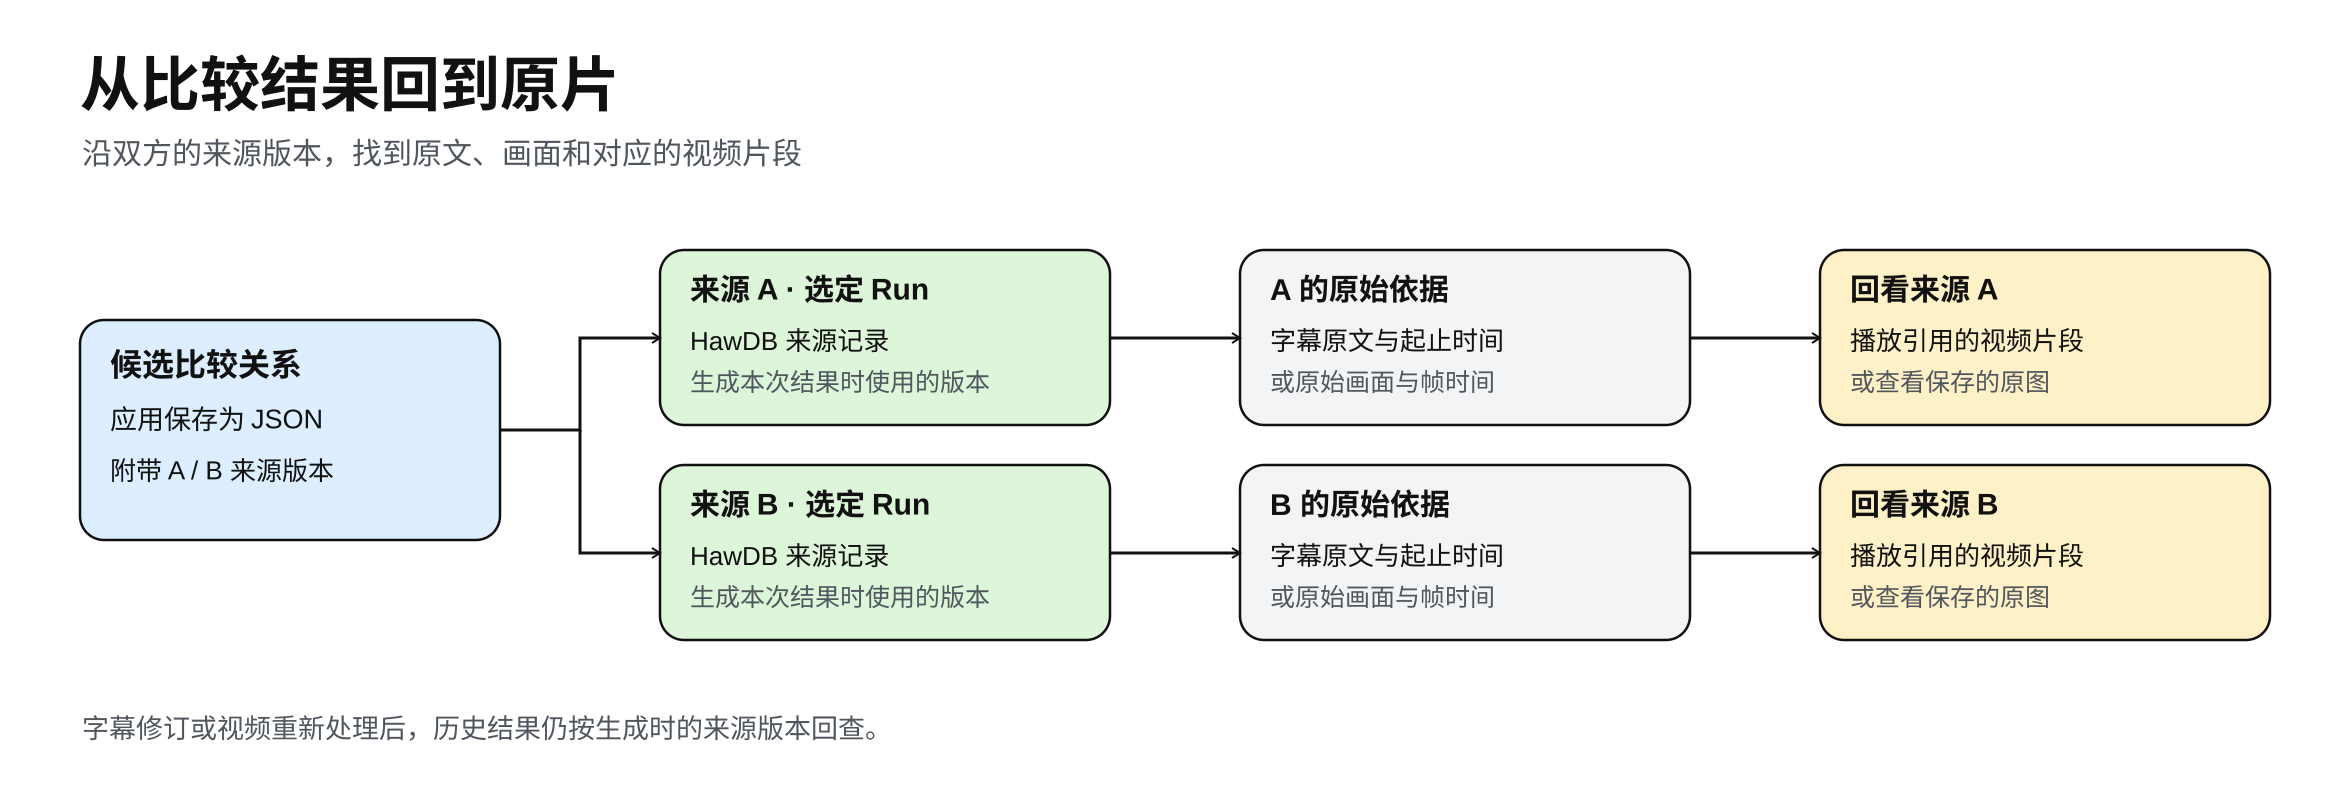
播放字幕片段时,在检索到的时间范围内向前、向后各延长最多 3 秒,便于查看上下文。画面引用可以跳转到帧时间并查看原图。历史结果仍保留当时的来源版本、处理配置与材料。
以 A 中“三分钟左右的 4K 60 帧视频”为例,数据沿同一条引用流转如下。此表不代表当时启用了可选的向量检索。
| 阶段 | 传递的数据 | 对后续步骤的作用 |
|---|---|---|
| 材料保存 | 字幕原文、起止时间、证据编号、run_id | HawDB 保存证据及来源版本,供应用读取 |
| 候选片段组织 | 片段编号、顺序字幕及关联画面 | 应用整理模型输入 |
| Vane 模型调用 | evidence_id、first_cue、last_cue 及提取字段 | 模型用片段编号与字幕范围指出引用;此处 evidence_id 对应候选片段编号 |
| 引用恢复 | 原始字幕、时间与来源版本 | 应用校验编号、范围,再恢复引用 |
| 比较与回看 | 比较标签、双方说法与原片位置 | 页面展示结果,提供回看入口 |
模型没有将录制时长填入条件字段,但引用原文保留了这项信息。Vane 返回可检查的字段和引用范围,HawDB 保存回查所需的材料与来源关系,应用负责将两者对应起来。
同一“性能与散热”话题下,读者关心的场景可能不同。下图汇总四位博主的相关片段:想了解温升测试方法,可以先看极客湾;关心持续录制的发热,可以选择钟文泽。摘要旁的时间可用于跳转播放,片段也能加入待看清单。
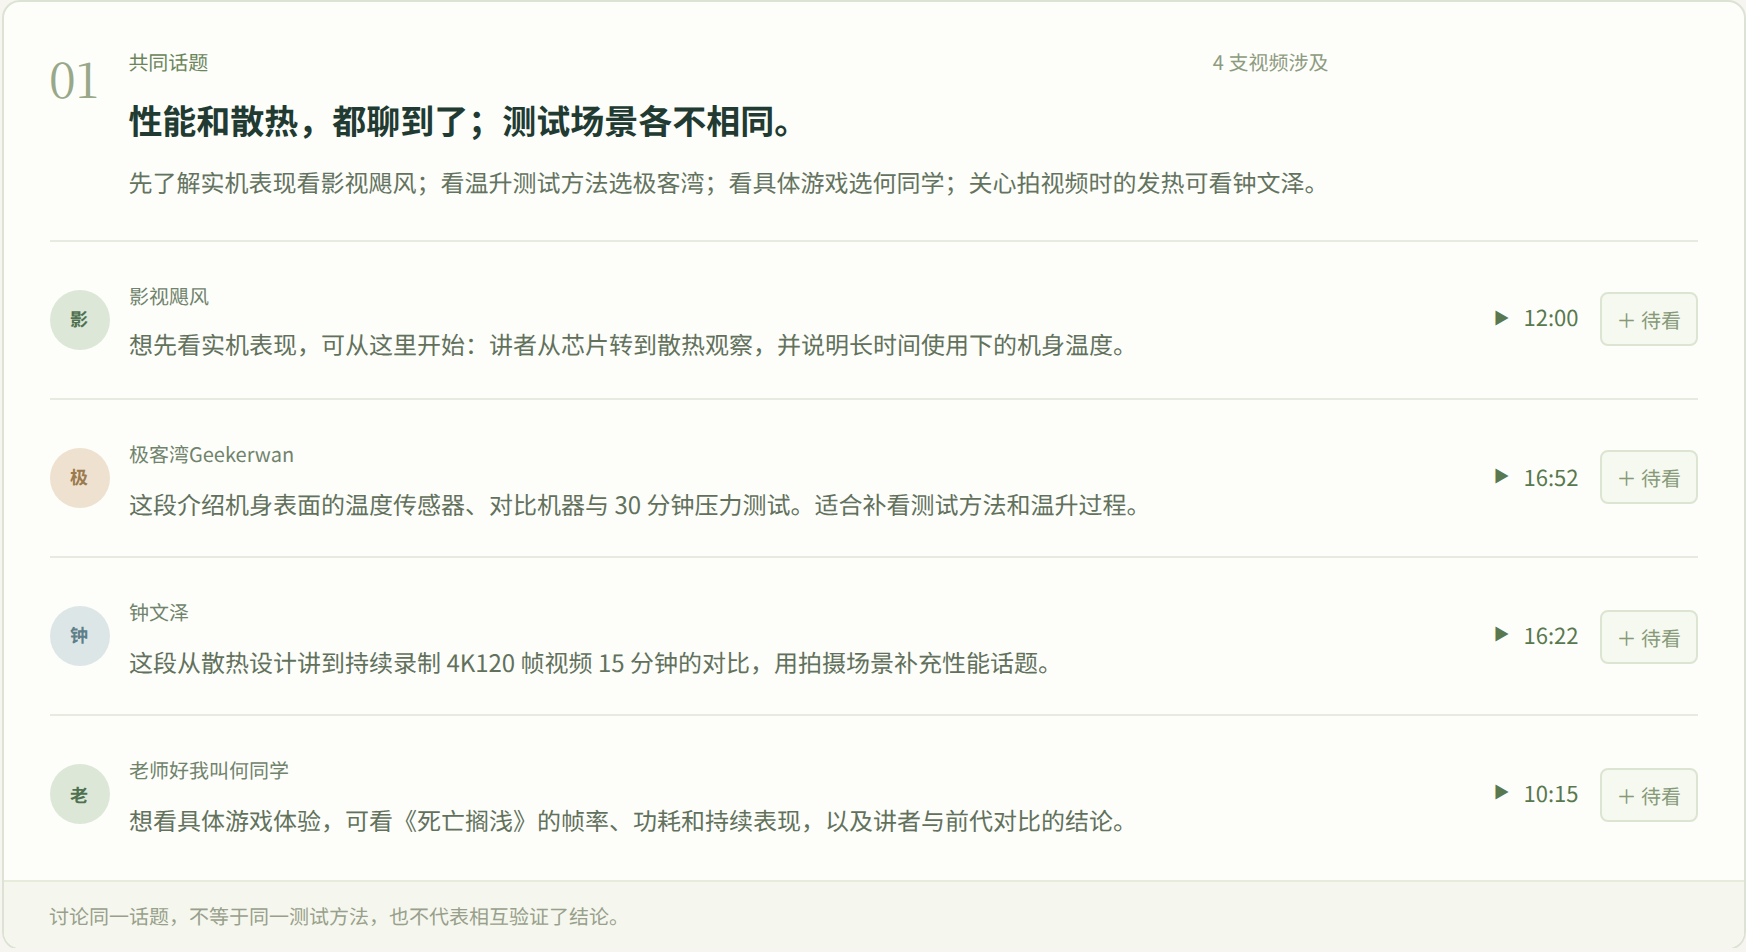
这些片段围绕“性能与散热”另外选取,与前面 A、B 的引用不完全相同。同属一个话题,也需要分别核对条件。
以极客湾为例,点击 16:52 查看温度传感器和对比机型,再结合右侧 17:08 的“30 分钟压力测试”字幕确认时长。通过播放器上方的来源按钮,可以切换到其他博主的片段。
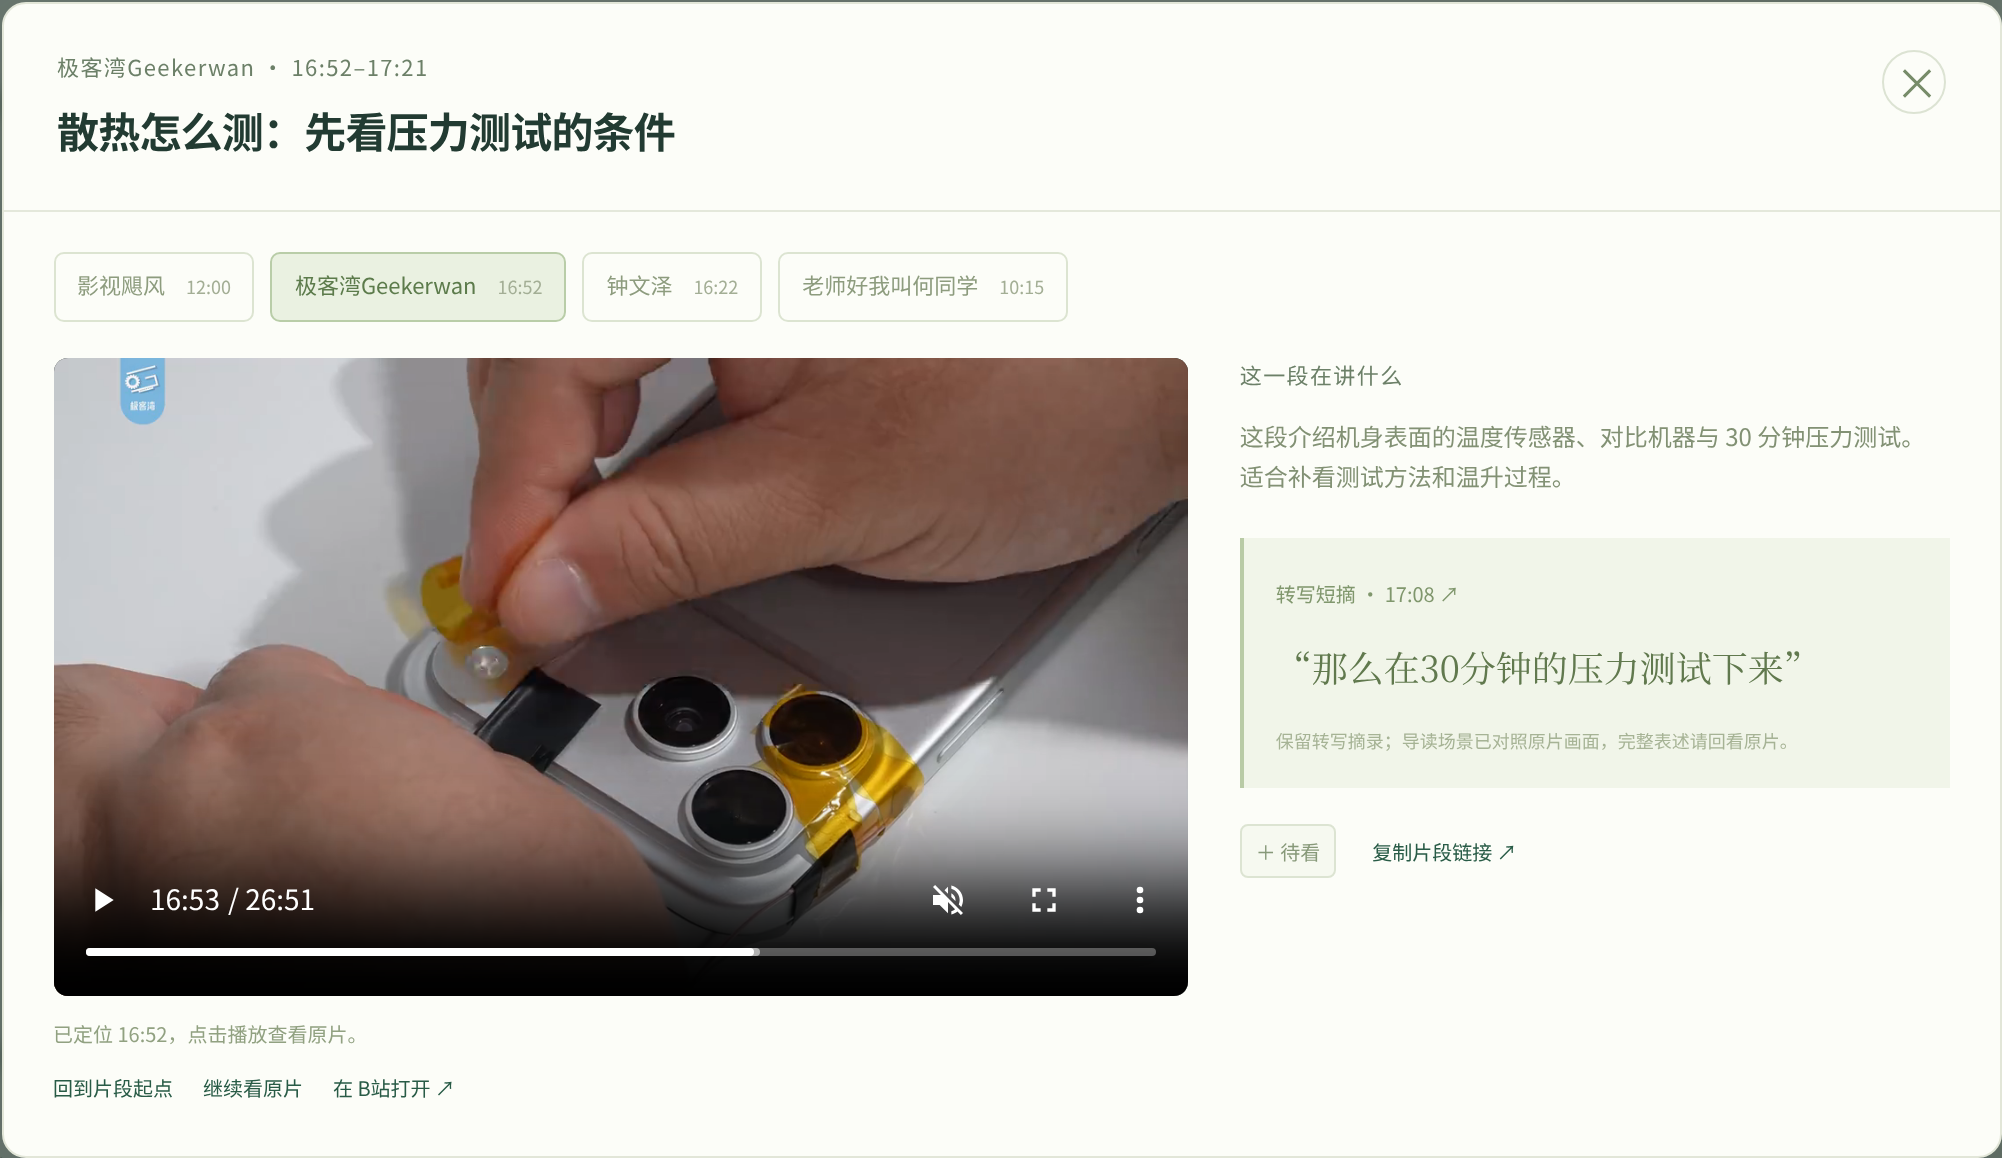
左侧视频播放至 16:53,右侧对应 17:08 的内容。读者可结合两处信息核对背景,也可点击“继续看原片”或“在 B 站打开”查看后续内容。
结合原文和人工回查,可以给 A、B 两段整理出以下观看建议:
| 读者关心的问题 | 可先查看的材料 | 阅读时注意 |
|---|---|---|
| Duo 录制视频时,局部发热与握持感受如何? | A:影视飓风,12:46–13:16 | 约三分钟 4K60 录制的体验描述 |
| Pro Max 的正面热平衡温度是多少? | B:极客湾,17:23–17:37;从 17:08 补看时长 | 区分图表中的两代机型;30 分钟高负载烤机 |
| 两段描述是否矛盾? | 对照双方对象、原文与条件 | 对象和场景不同,不能作为同一机型的冲突结论 |
| 能否判断散热改进的收益与代价? | 继续查找相应型号与条件下的对照材料 | 当前片段依据不完整 |
这些建议只针对选定片段,不能代表视频的全部内容。
系统区分找到相关依据、未提取到相关说法、部分提取失败和处理失败。字段被移除时仍保留原始内容;没有提取到说法,不代表作者没有讨论过。
数据复用与增量处理
保存的字幕、画面与来源信息可以用于后续分析。例如,从四支视频增加到五支时,满足缓存条件便可复用原有四支视频的提取结果与六组比较,只处理新增视频,以及它与原有四支的四组比较。
复用条件:原有问题、模型配置、处理协议、执行方式(runner)和来源版本均未变化,且此前的分析结果完整。
提出新问题时,可以复用已有材料,重新检索、提取和比较。模型、规则或原始材料变化时,应用更新相应结果,同时保留历史比较使用的来源版本。
这套分工也适用于课程资料问答、产品研究和多来源知识整理:Vane 处理文本、图像和视频并调用模型,HawDB 保存内容关系与来源,应用将检索和分析结果绑定到可回查的出处。